Área 3. Estadística y probabilidad
Estadística y Probabilidad: medidas de posición, variabilidad y probabilidad clásica
Al terminar vas a poder explicar por qué la varianza eleva al cuadrado, calcular cuartiles y percentiles con la fórmula de posición, decidir cuál medida de dispersión conviene en cada caso, y aplicar Laplace sabiendo cuándo se puede y cuándo no.
Medidas de posición: partir los datos ordenados
Una medida de posición corta un conjunto ordenado en partes iguales. Son la misma idea con distinta cantidad de cortes:
- Cuartiles (Q): cortan en 4. Q₁ deja abajo el 25 %, Q₂ el 50 % —la mediana— y Q₃ el 75 %.
- Deciles (D): cortan en 10. D₅ vuelve a ser la mediana.
- Percentiles (P): cortan en 100. P₅₀ también es la mediana.
Son el mismo instrumento con distinta finura, y por eso se convierten: Q₁ = P₂₅ = D₂,₅. Con los percentiles tenés los otros dos.
Lo primero es ordenar de menor a mayor: sin orden, «la posición 3» no significa nada.
Después se calcula la posición del corte con L = (k ÷ 100) × n, con k el percentil y n la cantidad de datos. L no es el valor: es el lugar de la fila donde hay que buscarlo.
- Si L da entero, el corte cae entre dos datos: se toma el promedio del dato L y el siguiente.
- Si no da entero, se interpola entre los dos datos vecinos según la parte decimal.
Medidas de variabilidad: por qué hay que elevar al cuadrado
Dos grupos con la misma media pueden ser muy distintos. La media dice dónde está el centro; la variabilidad, qué tan lejos se le van los datos.
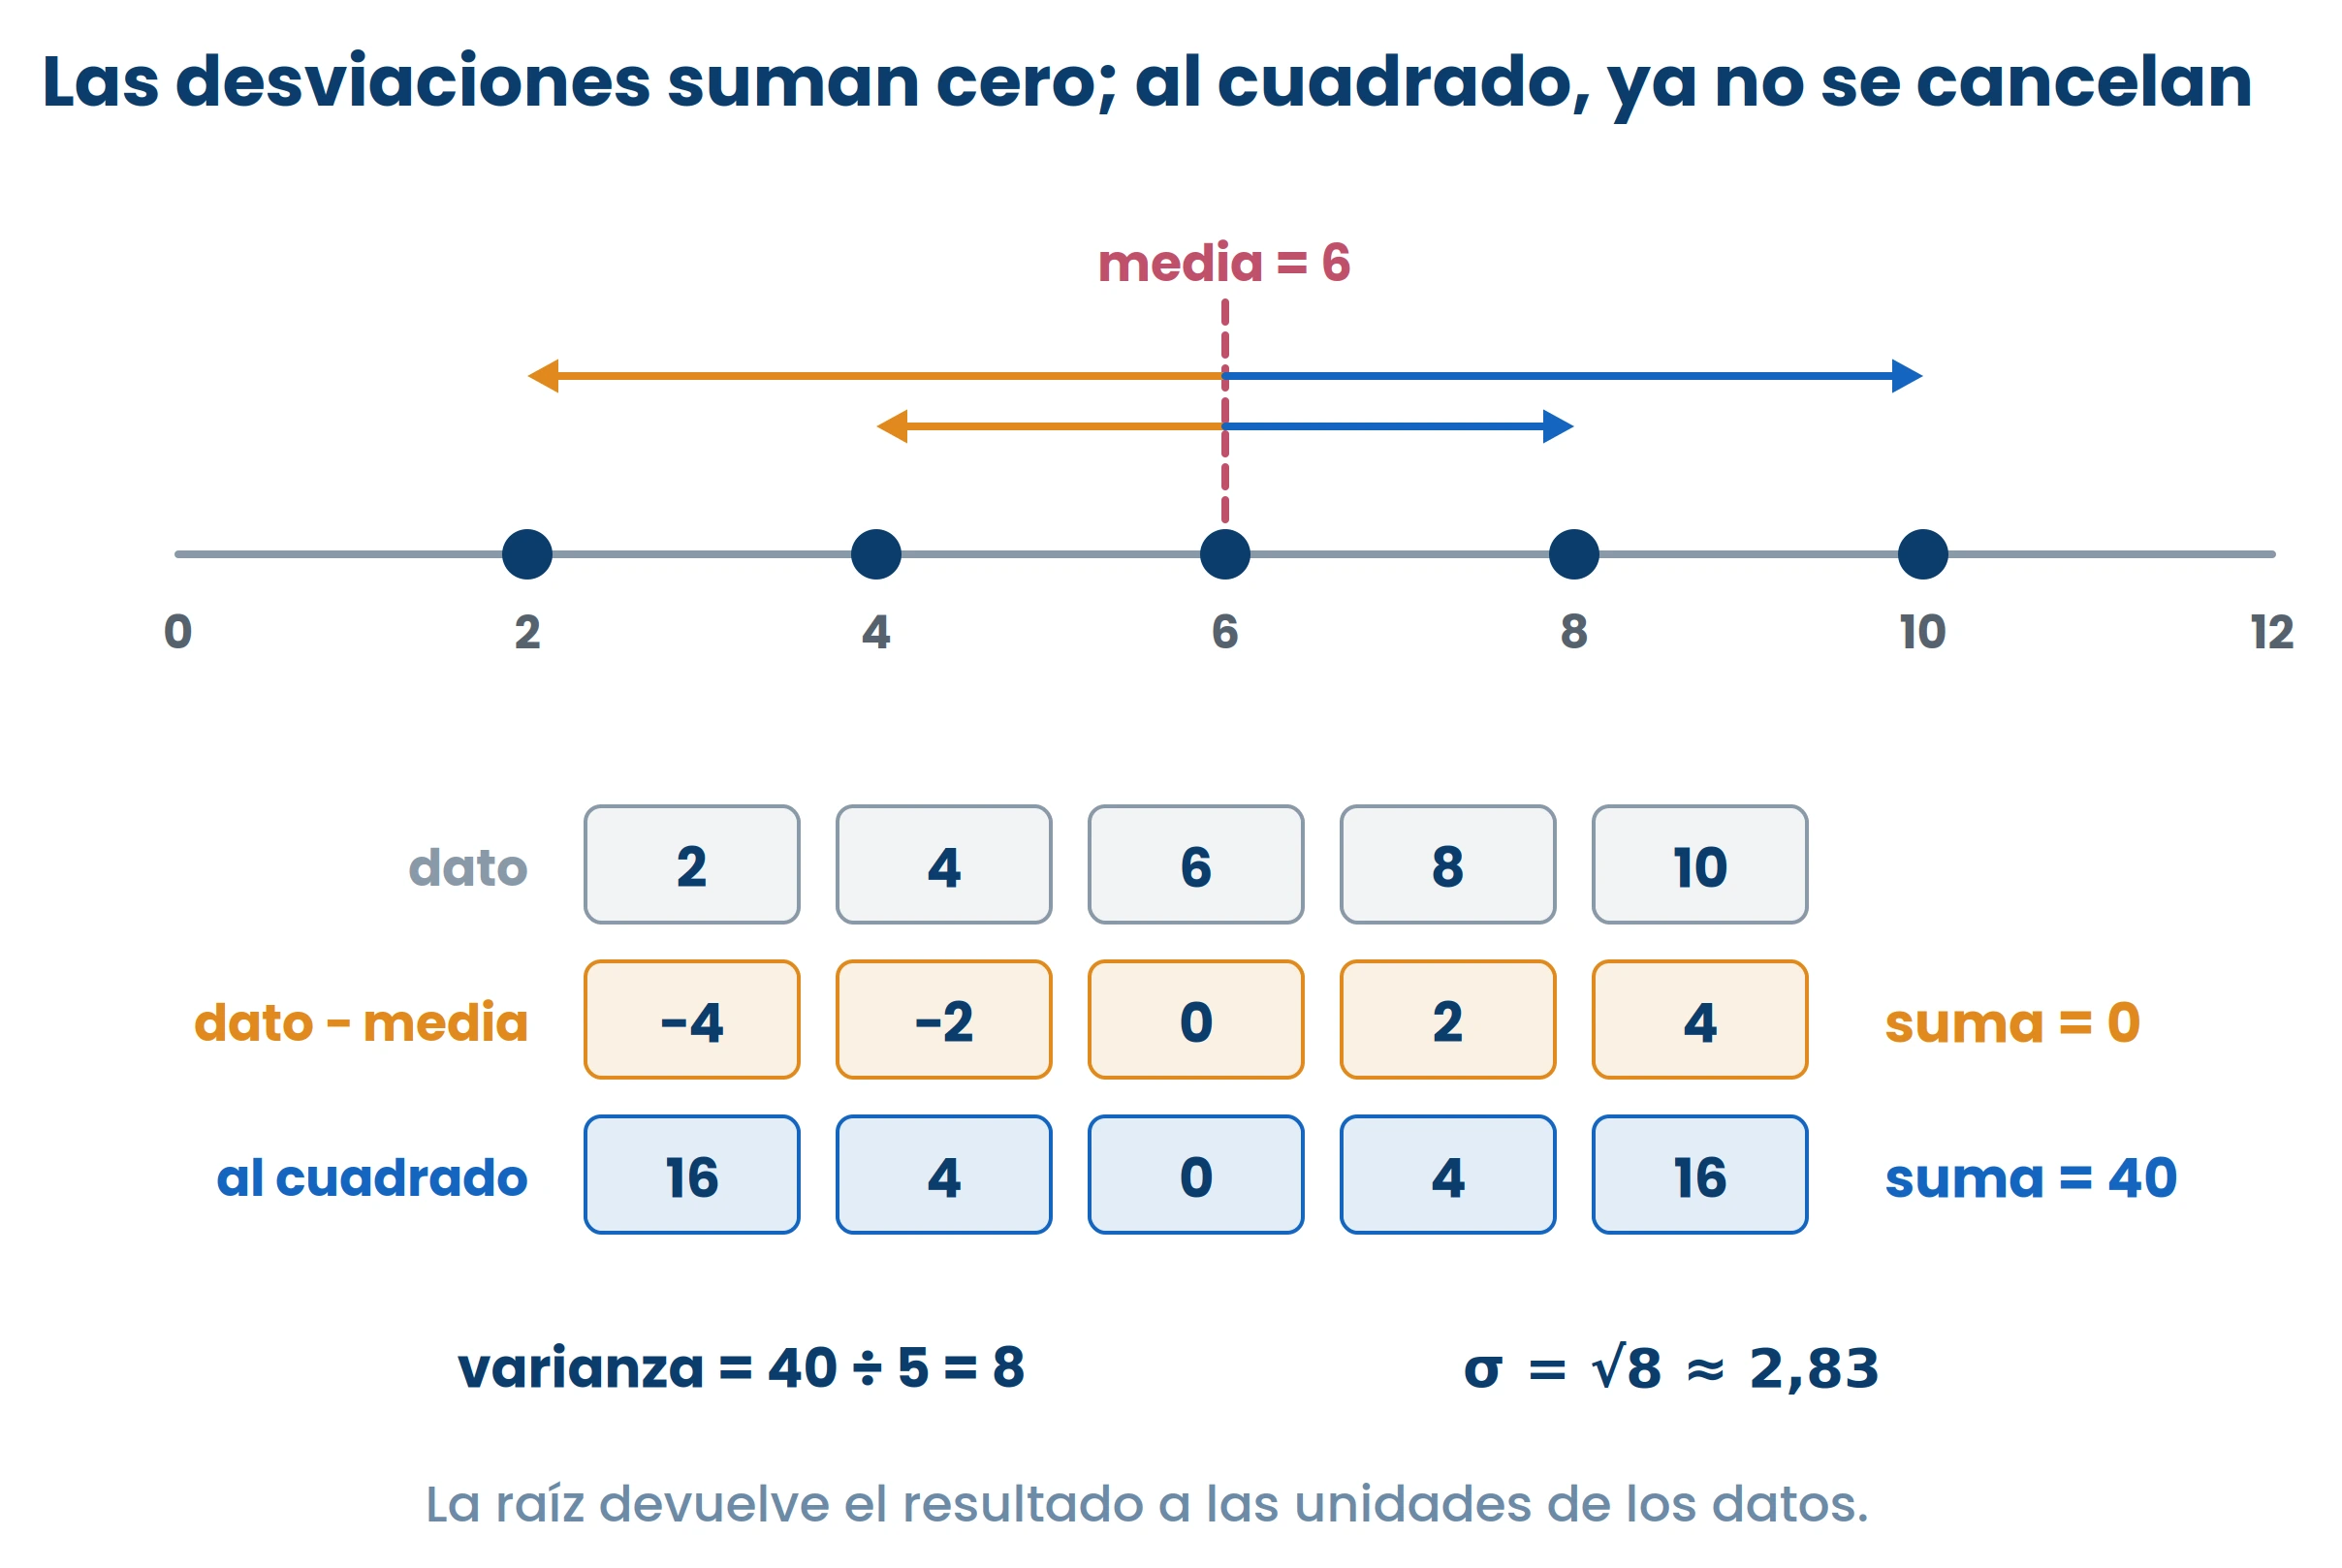
El primer intento sería promediar las desviaciones (dato − media). No sirve, y se prueba: las positivas y las negativas se cancelan y la suma siempre da cero. De ahí la solución: elevarlas al cuadrado, porque el cuadrado borra el signo y ya nada se cancela.
- Varianza: promedio de los cuadrados de las desviaciones. Queda en unidades al cuadrado: si medías colones, da colones cuadrados, que no significa nada.
- Desviación estándar (σ): la raíz de la varianza. La raíz deshace el cuadrado y devuelve el resultado a las unidades originales; por eso es la que se interpreta.
- Rango: máximo − mínimo. Mira solo los extremos, así que un dato raro lo dispara.
- Rango intercuartílico (RIC): Q₃ − Q₁. Mide el 50 % central, y como deja afuera las colas, no se altera con datos extremos.
Probabilidad clásica: qué exige la regla de Laplace
Cuando todos los resultados son igualmente probables, vale la regla de Laplace:
P(E) = favorables ÷ posibles
La condición no es un detalle: sin equiprobabilidad la división no mide nada. En un dado se cumple; en «llueve o no llueve», no. De esa definición salen todas las propiedades, y ninguna hay que recordarla suelta:
- 0 ≤ P(E) ≤ 1, porque los favorables son parte de los posibles: una parte no supera al todo ni baja de cero.
- P(evento seguro) = 1, porque ahí favorables y posibles son lo mismo; P(imposible) = 0, porque no hay favorables.
- P(no E) = 1 − P(E), porque E y su complemento no se dan juntos y entre los dos cubren todo: suman 1.
- Mutuamente excluyentes: si A y B no pueden darse a la vez, sus casos favorables no se repiten: P(A o B) = P(A) + P(B).
- Independientes: si uno no afecta al otro, P(A y B) = P(A) × P(B), porque por cada caso de A hay todos los de B.
Ejemplos resueltos
1. Con los datos 4, 7, 7, 9, 10, 12, 15, 16, calculá la media y la desviación estándar. Media: 80 ÷ 8 = 10. Desviaciones: −6, −3, −3, −1, 0, 2, 5, 6, que suman 0, como tiene que pasar siempre. Cuadrados: 36, 9, 9, 1, 0, 4, 25, 36 → 120. Varianza = 120 ÷ 8 = 15, y σ = √15 ≈ 3,87, en las unidades de los datos.
2. Con esos mismos datos, hallá Q₁, la mediana, Q₃ y el RIC. Ya están ordenados y n = 8. Q₁: L = 0,25 × 8 = 2, entero, así que se promedian el dato 2 y el 3: 7. Mediana: L = 4 → (9 + 10) ÷ 2 = 9,5. Q₃: L = 6 → (12 + 15) ÷ 2 = 13,5. RIC = 13,5 − 7 = 6,5. El rango es 16 − 4 = 12: casi el doble, porque incluye las colas.
3. En 4, 6, 7, 9, 10, 12, 13, 15, 18 (n = 9), calculá P₂₅. L = 0,25 × 9 = 2,25, no entero. Se interpola entre el dato 2 y el 3: 6 + 0,25 × (7 − 6) = 6,25, que cae entre los dos vecinos, como debe ser.
4. Dos grupos: A = 9, 10, 11 y B = 2, 10, 18. Compará centro y dispersión. Las dos medias dan 10: por el centro son idénticos. Varianza de A: (1 + 0 + 1) ÷ 3 ≈ 0,67, σ ≈ 0,82. Varianza de B: (64 + 0 + 64) ÷ 3 ≈ 42,67, σ ≈ 6,53. Misma media, dispersión ocho veces mayor: la media sola no describe un conjunto.
5. Urna con 4 bolas rojas y 6 azules: calculá P(roja), P(no roja), P(roja o azul) y P(dos rojas con reposición). P(roja) = 4 ÷ 10 = 0,4. P(no roja) = 1 − 0,4 = 0,6, que coincide con 6 ÷ 10: la comprobación cierra. Roja y azul son excluyentes y cubren todo: P(roja o azul) = 1. Con reposición la segunda extracción no depende de la primera, así que son independientes: 0,4 × 0,4 = 0,16. Sin reposición ya no lo serían.
Los errores que más se cobran
- Calcular un cuartil sin ordenar los datos. La fórmula da una posición, y en una lista desordenada apunta a cualquier cosa.
- Confundir la posición L con el valor del percentil. L dice dónde buscar; el percentil es el dato que está ahí. Dar 2,25 como P₂₅ es entregar el lugar.
- Reportar la varianza como si fuera la dispersión interpretable. Está en unidades al cuadrado; la que se compara con los datos es la desviación estándar.
- Usar el rango cuando hay un dato extremo. Un valor raro lo agranda entero. Si la pregunta habla de datos atípicos, corresponde el RIC.
- Creer que dos conjuntos con la misma media son parecidos. La media ubica el centro y nada dice de la separación: por eso se pide una medida de variabilidad junto a ella.
- Aplicar Laplace sin equiprobabilidad. «Gana o no gana: 1 ÷ 2» es la trampa clásica. Sin resultados igualmente probables hay que estimar con datos observados, no dividir.
Clave de análisis
Todo el bloque se reconstruye desde tres decisiones que tienen causa. La primera: las medidas de posición son un solo instrumento con distinta finura y todas se calculan igual —ordenar, hallar la posición con L = (k ÷ 100) × n, leer el dato—, y por eso Q₁, D₂,₅ y P₂₅ son el mismo número. La segunda: la variabilidad eleva al cuadrado porque las desviaciones sin elevar suman cero siempre, y después saca raíz para volver a las unidades del problema.
La tercera es que todas las reglas de probabilidad salen de contar casos: el complemento resta porque E y no-E cubren todo, los excluyentes suman porque no comparten casos, y los independientes multiplican porque cada caso de uno se combina con todos los del otro. Y sobre cualquier resultado queda el control que más ítems salva: una probabilidad cae entre 0 y 1. Si da 1,4, el error está en el denominador o en haber sumado eventos que sí podían ocurrir juntos.